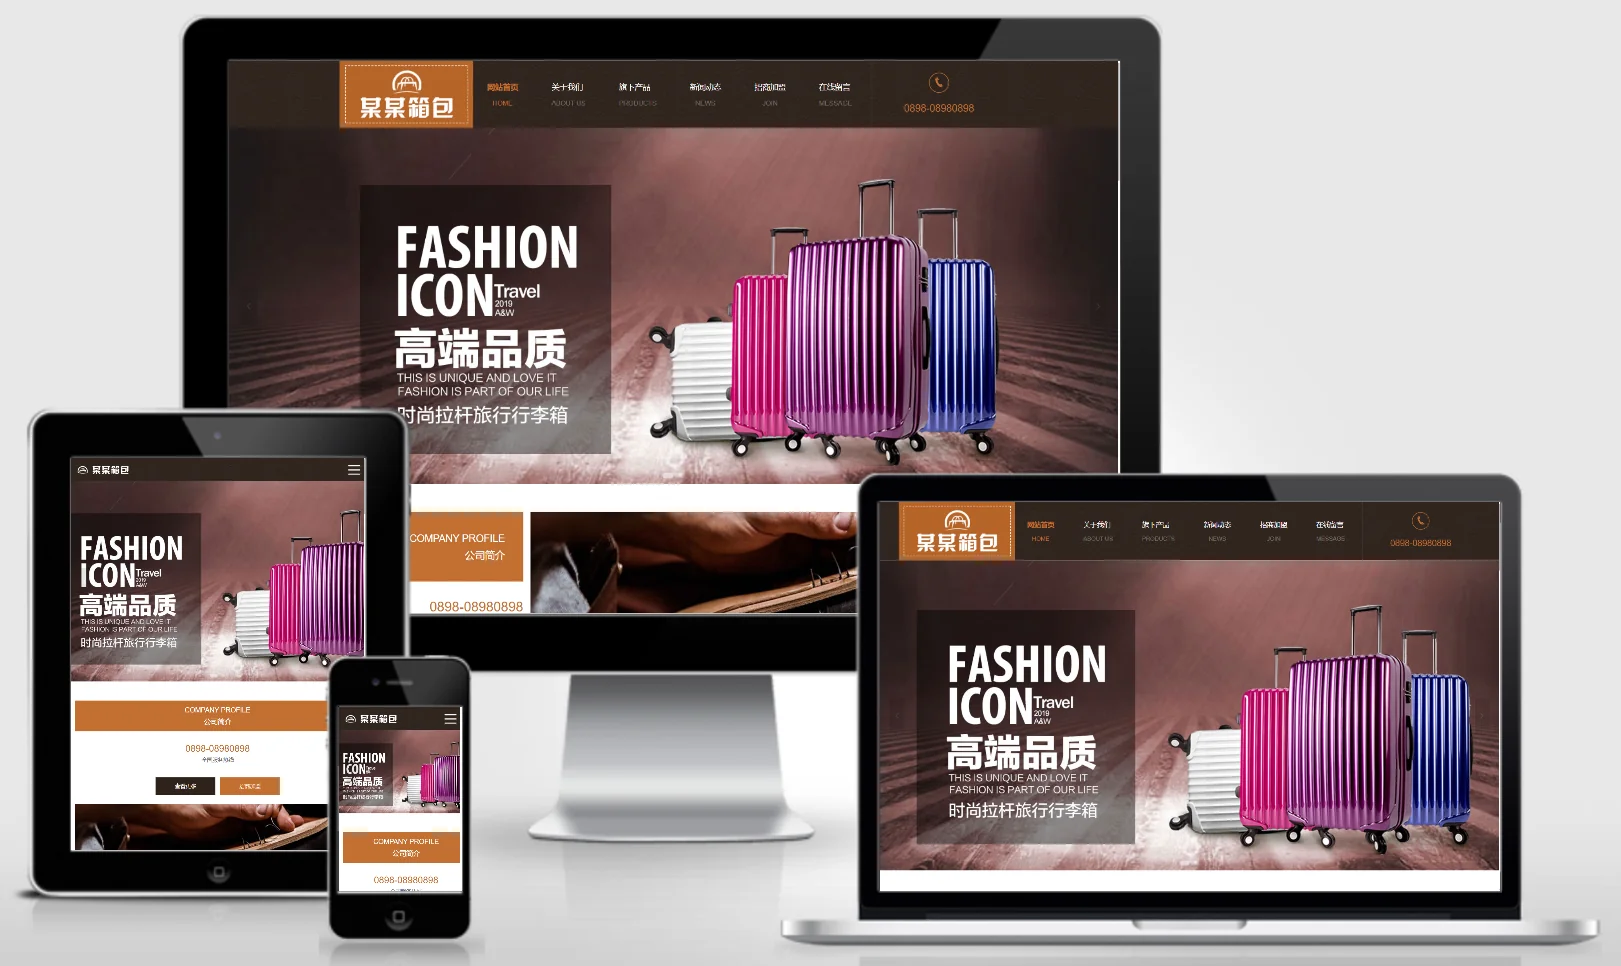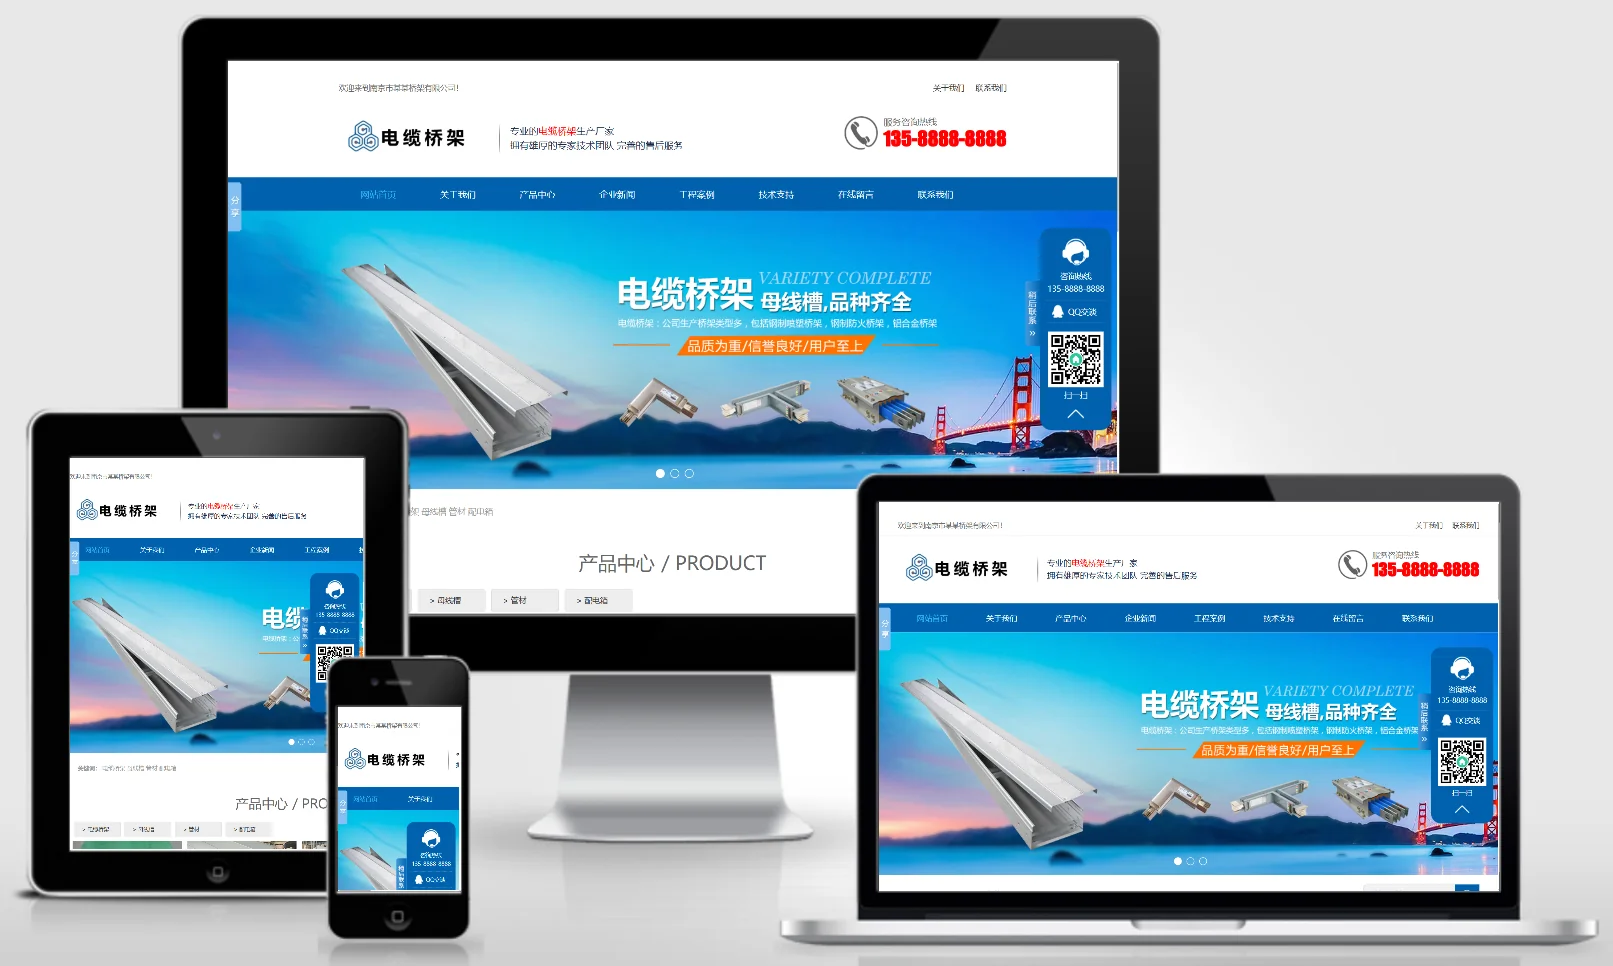
通過fidder抓包,然後寫的python腳本。
採集文章後,然後發佈到網站,很是方便。
但是這個腳本只適合本站使用。
目前把代碼放在這裏,留作備份。
import requests
import pandas as pd
import re
import time
import os
import json

# ---------- 配置 ----------
EXCEL_PATH = r"C:\Users\18102\Downloads\jietu\1.xlsx"
AJAX_URL = "https://www.4s5.cn/wp-admin/admin-ajax.php"
CATEGORY_ID = 41

EXCEL_DIR = os.path.dirname(EXCEL_PATH)
PUBLISHED_LOG = os.path.join(EXCEL_DIR, "published.txt")
LOG_PATH = os.path.join(EXCEL_DIR, "publish.log")

# 完整的 Cookie(請確保有效)
COOKIE_STRING = ""

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/150.0.0.0 Safari/537.36",
    "X-Requested-With": "XMLHttpRequest",
    "Referer": "https://www.4s5.cn/newposts",
    "Origin": "https://www.4s5.cn",
    "Content-Type": "application/x-www-form-urlencoded; charset=UTF-8",
    "Cookie": COOKIE_STRING,
}

RECOMMENDED_ARTICLES = [
    ("1790", "PbootCMS 安全運維完全指南"),
    ("1788", "pbootcms源碼安裝教程,後臺密碼,頁面空白處理"),
    ("1785", "pbootcms僞靜態設置教程"),
]

# ---------- 輔助函數 ----------
def extract_id_and_title(filename):
    match = re.match(r'^(\d{4})_(.+?)\.zip$', filename)
    if match:
        return int(match.group(1)), match.group(2)
    return None, filename

def build_post_content(desc, site_id):
    if desc and isinstance(desc, str) and len(desc.strip()) > 10:
        sentences = [s.strip() for s in desc.split('。') if s.strip()]
        desc_html = ''.join([f'<p>{s}。</p>' for s in sentences])
    else:
        desc_html = '<p>這是一款優質的PbootCMS網站模板,適合各類企業建站需求。模板設計美觀,功能完善,歡迎下載使用。</p>'

    img_url = f"https://www.4s5.cn/wp-content/uploads/{site_id:04d}.com.png"
    img_html = f'<h3>模板展示</h3><p><img src="{img_url}" alt="模板截圖"></p>'

    install_html = '''
    <h3>安裝說明</h3>
    <p>網站後臺:/admin.php</p>
    <p>賬號:admin</p>
    <p>密碼:admin</p>
    '''

    password_html = '<p>解壓密碼:www.4s5.cn</p>'

    rec_html = '<h3>相關文章</h3><ul>'
    for post_id, title in RECOMMENDED_ARTICLES:
        rec_html += f'<li><a href="https://www.4s5.cn/archives/{post_id}.html" target="_blank">{title}</a></li>'
    rec_html += '</ul>'

    return desc_html + img_html + install_html + password_html + rec_html

# ---------- 日誌記錄 ----------
def log_response(site_id, response_text, success_flag=False):
    with open(LOG_PATH, 'a', encoding='utf-8') as f:
        f.write(f"=== Site {site_id:04d} ===\n")
        f.write(response_text + "\n")
        f.write("--- 標記爲成功 ---\n" if success_flag else "--- 標記爲失敗 ---\n")
        f.write("\n")

# ---------- 已發佈記錄管理 ----------
def load_published_ids():
    if not os.path.exists(PUBLISHED_LOG):
        return set()
    with open(PUBLISHED_LOG, 'r', encoding='utf-8') as f:
        return {line.strip() for line in f if line.strip()}

def save_published_id(site_id):
    with open(PUBLISHED_LOG, 'a', encoding='utf-8') as f:
        f.write(f"{site_id:04d}\n")

# ---------- 主程序 ----------
def main():
    published_ids = load_published_ids()
    print(f"📋 已發佈 {len(published_ids)} 篇。")

    df = pd.read_excel(EXCEL_PATH)
    df = df.sort_values('站點id').reset_index(drop=True)
    print(f"📊 Excel 共 {len(df)} 條記錄。")

    auto_mode = False  # 是否自動發佈模式

    for idx, row in df.iterrows():
        site_id = int(row['站點id'])
        site_id_str = f"{site_id:04d}"

        if site_id_str in published_ids:
            print(f"⏭️ 站點 {site_id_str} 已發佈,跳過。")
            continue

        filename = row['文件名']
        link = row['鏈接']
        desc = row.get('描述', '')

        sid, title_part = extract_id_and_title(filename)
        if sid is None:
            print(f"❌ 文件名格式錯誤:{filename},跳過。")
            continue

        if not auto_mode:
            print(f"\n📌 當前準備發佈:{site_id_str} - {title_part}")
            print("   選項:")
            print("     按 回車  → 發佈")
            print("     輸入 2   → 跳過(不記錄)")
            print("     輸入 3   → 退出腳本")
            print("     輸入 4   → 自動發佈(此後不再詢問)")
            choice = input("請選擇:").strip()

            if choice == '3':
                print("🛑 用戶選擇退出。")
                break
            elif choice == '4':
                auto_mode = True
                print("🚀 已切換爲自動發佈模式,將連續發佈所有剩餘站點。")
                # 當前站點繼續發佈(不跳過)
            elif choice == '2':
                print(f"⏭️ 跳過站點 {site_id_str}。")
                continue
            elif choice == '':
                # 回車,發佈
                pass
            else:
                print("輸入無效,按回車鍵將視爲發佈。")

        # ---------- 執行發佈 ----------
        title = f"{title_part} {sid:04d}"
        content = build_post_content(desc, site_id)

        pay_download = {
            "link": link,
            "more": "解壓密碼:www.4s5.cn",
            "copy_key": "解壓密碼",
            "copy_val": "www.4s5.cn",
            "name": "百度網盤下載",
            "class": ""
        }

        data = {
            "post_title": title,
            "post_content": content,
            "category[]": CATEGORY_ID,
            "tags": "",
            "zibpay_s": "on",
            "posts_zibpay[pay_modo]": "0",
            "posts_zibpay[pay_price]": "0",
            "posts_zibpay[vip_1_price]": "0",
            "posts_zibpay[vip_2_price]": "0",
            "posts_zibpay[pay_download][0][link]": pay_download["link"],
            "posts_zibpay[pay_download][0][more]": pay_download["more"],
            "posts_zibpay[pay_download][0][name]": pay_download["name"],
            "posts_zibpay[pay_download][0][copy_key]": pay_download["copy_key"],
            "posts_zibpay[pay_download][0][copy_val]": pay_download["copy_val"],
            "posts_zibpay[pay_download][0][class]": pay_download["class"],
            "posts_id": "0",
            "action": "posts_save"
        }

        try:
            resp = requests.post(AJAX_URL, headers=HEADERS, data=data, timeout=30)
            resp_text = resp.text
            try:
                result = resp.json()
            except:
                result = {}

            # 成功判斷
            success = False
            if result.get('posts_id'):
                success = True
            elif result.get('error') == False:
                success = True
            elif '已發佈' in result.get('msg', ''):
                success = True

            log_response(site_id, resp_text, success_flag=success)

            if success:
                post_id = result.get('posts_id', '未知')
                print(f"✅ 發佈成功!站點 {site_id_str} -> 文章ID {post_id}")
                save_published_id(site_id)
                published_ids.add(site_id_str)
            else:
                error_msg = result.get('msg', '未知錯誤')
                print(f"❌ 發佈失敗!站點 {site_id_str},錯誤:{error_msg}")
        except Exception as e:
            print(f"❌ 異常:{e},站點 {site_id_str}")
            with open(LOG_PATH, 'a', encoding='utf-8') as f:
                f.write(f"=== Site {site_id:04d} ===\n")
                f.write(f"EXCEPTION: {str(e)}\n\n")

        time.sleep(1.5)

    print(f"\n🏁 腳本執行完畢。已發佈 {len(load_published_ids())} 篇。")

if __name__ == "__main__":
    main()